Column / Insights
AIサーバーおすすめ3選——ローカルLLMとフィジカルAI、用途で選ぶ【2026年10月】
ローカルLLMを動かすだけか、ロボットのシミュレーションや学習まで行うかで、必要なGPUメモリと値段は大きく変わります。Mac mini・RTX 5090・RTX PRO 6000の3台を、2026年10月の実売価格と、どのモデルが動くかで比べました。
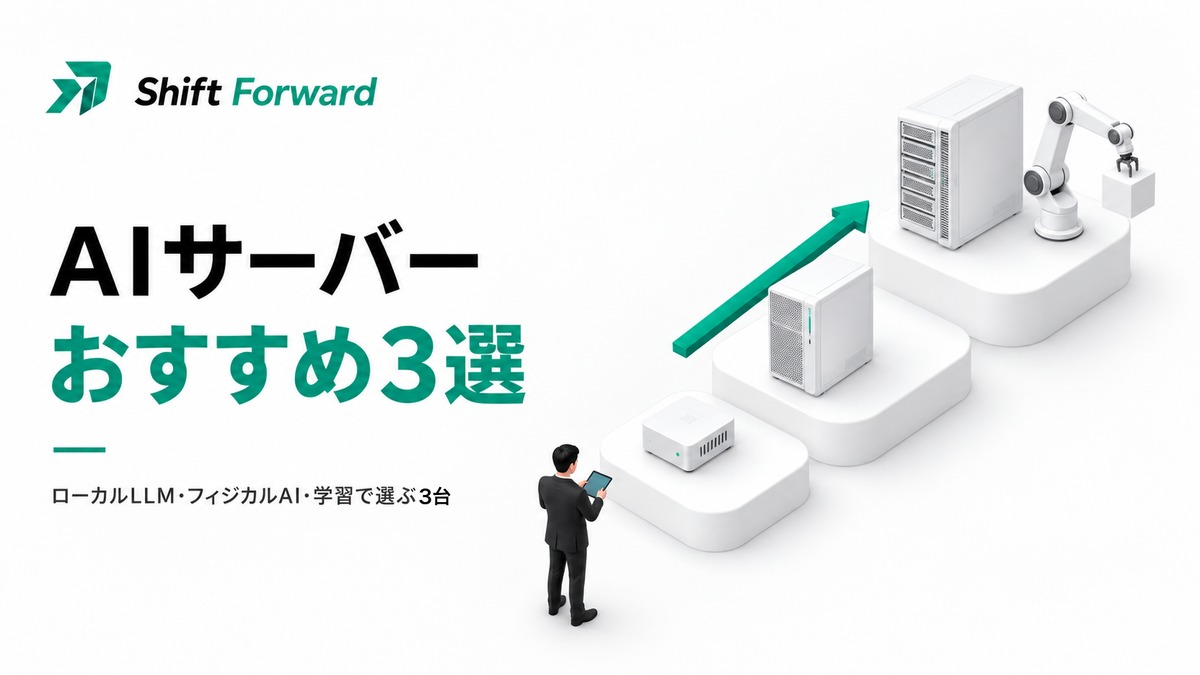
社内でAIを動かすマシンは、何に使うかによって必要なGPUメモリが大きく違います。
ローカルLLMを動かすだけなら、50万円台のMacで足ります。ただ、ロボットをAIで動かす「フィジカルAI」に取り組み、ロボットのシミュレーション(NVIDIAのIsaac Simなど)や、ロボット向けAIモデルの学習まで社内で行おうとすると、必要なGPUメモリが一気に増え、値段も数百万円の単位になります。
この記事では、ローカルLLM、ロボットのシミュレーション、ロボット向けAIモデルの学習の3段階に分けて、2026年10月初め時点で買える3台を選びました。
やりたいことで3台から選ぶ
3台の違いは、主にGPUメモリの量です。
| ローカルLLMまで | シミュレーションまで | 学習まで | |
|---|---|---|---|
| マシン | Mac mini(M5 Pro) | RTX 5090を積んだパソコン | RTX PRO 6000を積んだワークステーション |
| GPUメモリ | 64GB(メインメモリと共用) | 32GB | 96GB |
| 価格(税込) | 515,800円 | 約134万〜143万円 | 約355万円〜 |
| できること | ローカルLLM、一部のロボット向けAIモデル(π0.5など)の推論 | ローカルLLMに加えて、ロボットのシミュレーションと、ロボット向けAIモデルの部分的な学習 | シミュレーションに加えて、ロボット向けAIモデルの本格的な学習と、大きいLLM |
| 電気代の目安 | 年1万円ほど | 年7万円ほど | 年5万〜7万円ほど |
価格は、2026年10月初めに販売店のページで確認した完成品の価格です(筐体・電源込み)。電気代は、東京電力の従量電灯B(1kWhあたり40.49円)で、平日の日中(年1,920時間)に全力で動かした場合の目安です。24時間動かすと約4.6倍になります。燃料費調整額などは含みません。
ラックに入れるGPUサーバーは、確認した構成ではGPUを1枚積んだものでも1,000万円を超えたため、今回はパソコンとワークステーションから選びました。
動かしたいモデルで、必要なメモリが決まる
AIのモデルは、GPUのメモリに丸ごと載らないと実用的な速さで動きません。そのため、まず動かしたいモデルの必要メモリを確認し、それが載るマシンの中から選びます。
ローカルLLMは、30B級のモデルなら4bitに圧縮して16〜20GB、8bitで28〜35GBが目安です。ここに、会話の流れを覚えておくためのメモリが数GB加わります。機材選びの考え方は「AI時代のハードウェアの選び方」で詳しく紹介しています。
フィジカルAIでは、ロボットのシミュレーションに使うNVIDIAのIsaac Simを動かすのに、GPUメモリが16GB以上あり、RTコア(描画用の部品)を持つNVIDIAのGPUが必要です。ロボット向けAIモデルの学習は、さらにメモリを使います。
下の表の○は、公式の動作要件や必要メモリから見て載るもの、×は載らないか対応していないもの、△はメモリは足りるものの、公式の手順がNVIDIAのGPU向けのものです。実際の速さや、業務で使えるかどうかは別に確認が必要です。
ローカルLLM
| モデル | 必要なメモリ(4bit/8bit) | Mac mini | RTX 5090 | RTX PRO 6000 |
|---|---|---|---|---|
| 30B級のモデル (Qwen3.8-27B、Gemma 4 31Bなど) | 16〜20GB/28〜35GB | ○ | ○(4bit) | ○ |
| gpt-oss-120b(OpenAI) | 約65GB(標準で4bit相当) | × | × | ○ |
| Qwen3.8-Flash-Next (Alibaba、ファイル全体で約180B) | 105〜120GB/約189GB | × | × | × |
フィジカルAI
| やりたいこと | 必要なGPUメモリ | Mac mini | RTX 5090 | RTX PRO 6000 |
|---|---|---|---|---|
| Isaac Sim(ロボットのシミュレーション) | 16GB以上(RTコア必須) | × | ○ | ○ |
| GR00T N1.7の推論 | 16GB | × | ○ | ○ |
| GR00T N1.7の再学習 | 40GB以上 | × | × | ○ |
| π0.5の推論 | 8GB超 | ○ | ○ | ○ |
| π0.5のLoRA学習 | 22.5GB超 | △ | ○ | ○ |
| π0.5の全体学習(フルファインチューニング) | 70GB超 | × | × | ○ |
| LeRobotのSmolVLAの学習 | 10〜16GB | ○ | ○ | ○ |
| Cosmos Transfer2.5の推論 | 65GB | × | × | ○ |
1. Mac mini M5 Pro(ローカルLLMを試すならおすすめ)
Apple公式ストアで税込515,800円です(M5 Pro 18コアCPU・20コアGPU、メモリ64GB、SSD 512GB)。Macはメインメモリ(64GB)をGPUと共用するので、同じくらいの値段のNVIDIAのGPUより大きいモデルが載ります。モデルを何種類も置くなら、SSDは1TB以上にしておくと容量に困りません。
速さはモデルの作りで大きく変わります。Gemma 4 26B-A4Bのように一度に動く部分が小さいモデル(MoE)は、M5 Pro・64GBの実測では毎秒約70トークンで、待たずに使えます。Qwen3.8-27Bの4bit版は毎秒12〜15トークンの見込みで、ゆっくり文字が出る程度です。
ロボット向けAIモデルの推論も、Macで動くものがあります。筆者がπ0.5の推論をM1 Max(64GB)のMacで測ったところ、ロボットの動作50ステップ分をまとめて生成する1回あたりの時間が平均1,167ミリ秒で、30Hzで50ステップを動かす1,667ミリ秒に収まりました。実機の制御では、これにカメラ画像の取り込みや通信の時間が加わります。LeRobot(Hugging Faceのロボット用ライブラリ)や、MuJoCo・Genesisといった物理シミュレーションも動きます。一方で、Isaac SimやGR00Tのように、NVIDIAのGPUを前提にしたツールは動きません。
機密データを社外のAIに出せない会社が、まず社内でLLMを試すのに向いています。ただし、マシンを社内に置くだけで機密が守られるわけではなく、使うアプリの外部通信やログの保存先、誰が使えるかの設定も確認しておく必要があります。手元のPCで試すところから始めるなら、「ローカルLLMを自分のPCで試す」も参考にしてください。
gpt-oss-120bのような100B級のLLMも動かしたいなら、メモリ128GBのMac Studio(M5 Max、税込941,800円)も候補になります。こちらもIsaac SimやGR00Tは動きません。
2. RTX 5090のパソコン(Isaac Simでのシミュレーションまで行うなら)
GeForce RTX 5090(GPUメモリ32GB)は、ゲームや映像制作向けのGPUです。これを積んだパソコンの完成品が、メモリ64GB・SSD 2TBの構成で税込約134万〜143万円で売られています(マウスコンピューター、TSUKUMO、サイコム)。
RTX 5090は、Isaac Simの動作要件でNVIDIAが中位としている構成(RTX 5080、16GB)を上回ります。Isaac Simを動かすだけなら16GBのGPUを積んだパソコンでも動きますが、GR00Tの推論(16GB)やπ0.5のLoRA学習(22.5GB超)、LLMを同じ1台で扱うことを考えて、32GBのRTX 5090を選びました。LeRobotのSmolVLAの学習(10〜16GB)もできます。
GPUメモリが32GBなので、GR00Tの再学習(40GB以上)やπ0.5のモデル全体の学習(70GB超)はできず、gpt-oss-120bのような大きいLLMも載りません。LLMはQwen3.8-27Bの4bit版が載ります。メモリの帯域(データを読み出す速さ)がMac mini M5 Proより広いので、同じモデルならMac miniより速く動きます。参考に、同じ30B級のMuse Glimmer 30Bは、RTX 5090で毎秒約75トークン出ています。
既存のロボット向けAIモデルを、シミュレーションで試しながら自社の作業に合わせて軽く調整したい会社には、このパソコンが向いています。
3. RTX PRO 6000のワークステーション(学習まで社内で行うなら)
RTX PRO 6000 Blackwell(GPUメモリ96GB)は業務用のGPUです。これを積んだワークステーションの完成品は、省電力版(Max-Q、300W)を積んだものが税込約355万円、通常版(Workstation Edition、600W)を積んだものが約365万円からです(ジーデップ・アドバンス、パソコン工房など)。省電力版は消費電力と発熱が少ないぶん、計算は通常版より遅めです。
Isaac Simの動作要件で、NVIDIAがいちばん上の推奨にしているのがこのGPUです。GR00T N1.7の言語・画像の部分まで含めた再学習(80GB以上)、π0.5のモデル全体の学習(70GB超)、シミュレーションの映像を実写風に変換するNVIDIAのCosmos Transfer2.5(推論に65GB)、gpt-oss-120b(約65GB)のような100B級のLLMまで、必要メモリの上では1枚に収まります。
GR00Tを実運用の規模で学習する場合は、これでも足りません。NVIDIAの推奨はRTX PRO 6000を8枚で、ワークステーションには収まらないためサーバーが必要です。学習を年に数回行うだけなら、買わずにクラウドで借りる方が安く済むこともあります(詳しくは後述の「買うか、借りるか」をご覧ください)。
番外:DGX Sparkはどうか
NVIDIAの小型AIマシンDGX Sparkは、メモリ128GB(CPUとGPUで共用)で、国内では約98万〜119万円で売られています(パソコン工房、TSUKUMO。2026年10月初めの時点では、どちらも在庫切れでした)。
値段はMac miniとRTX 5090のパソコンの間ですが、メモリの量だけならRTX PRO 6000(96GB)より多い128GBです。gpt-oss-120bのような大きいLLMも載り、NVIDIAのGPUなのでGR00Tも動きます。GR00T N1.7の推論は毎秒10.1回で、NVIDIAが推奨する下限(毎秒10回)とほぼ同じです。Isaac Simも動きますが、ライブストリーミングなど一部の機能には対応していません。
3台に入れなかったのは、速さの面で不利だからです。メモリの帯域は273GB/sで、Mac mini M5 Pro(307GB/s)よりやや狭く、数字の上ではRTX 5090より文章の生成がかなり遅くなる見込みです。速さより、大きいモデルを載せることやNVIDIAのツールを手元で試すことを優先するなら候補になります。
買う前の注意点
導入後の設定と運用を誰が担当するか
買った後は、LLMを社内で使えるようにする推論サーバーの設定、誰が使えるかの管理、ドライバの更新、故障したときの対応が必要です。学習用のツールの多くはLinux(Ubuntu)向けなので、注文時にLinuxを入れて届けてもらうか、届いてから入れ直します。専任の担当者がいない会社では、こうした作業を誰が担当するかを先に決めておく必要があります。
置き場所と電源
RTX 5090のパソコンとRTX PRO 6000のワークステーションは、1kW近く使います。100Vで動く機種がありますが、電源の仕様は機種ごとに違うので、注文前に販売店に確認してください。ほかの機器と同じ回路だとブレーカーが落ちることがあるため、専用の回路を用意してください。熱と音も出るので、人のいる席から離して置き、夏場の空調も考えておく必要があります。
保証・納期・価格
保証の期間や、故障したときに出張で直すのか送って直すのかは、販売店や構成によって違います。業務で使うなら、保守の内容も比べて選ぶのがおすすめです。納期も、在庫切れや受注生産で変わります。2026年はメモリとGPUの値上がりが続いているため、価格は買う直前に改めて確認してください。
買うか、借りるか
RTX PRO 6000を国内でレンタルすると、1年契約で月159,500円(税込)、3年で約574万円です。RTX PRO 6000のワークステーションを買って3年、24時間使い続けた場合は、本体と電気代だけで約420万〜470万円です(保守や運用の手間、為替や料金の変化は含めていません)。海外のクラウド(RunPod)でRTX PRO 6000を借りると1時間2.09ドルで、平日の日中(年1,920時間)だけなら年約64万円です。使う時間が短いならこちらが安く済みますが、データを社外に出すことになります。
まとめ
最初の1台は、動かしたいモデルの必要メモリを表で確認し、○が付く中でいちばん安いマシンを選んでください。ローカルLLMを試すだけならMac miniで十分です。フィジカルAIは、シミュレーションと既存モデルの推論、軽い調整から始めるのが現実的で、そこまでならRTX 5090のパソコンで対応できます。本格的な学習が必要になった時点で、RTX PRO 6000を買うかクラウドで借りるかを決めても遅くありません。どの場合も、導入後の設定と運用の担当者は買う前に決めておいてください。